moton16/dsh-vision-mcp
Give your text-only LLM eyes: zero-dependency MCP server that reads images via external OpenAI-compatible vision models with automatic provider fallback, plus a one-command patch for DSH image-attachment degradation.
Project Overview项目介绍
dsh-vision-mcp is a zero-dependency MCP server that adds vision to text-only main models like DeepSeek. It exposes an img2text tool that sends local paths, URLs, data URLs, or base64 images to any OpenAI-compatible vision API (GPT-4o, Qwen-VL, GLM-4V, local Ollama, etc.) and returns a text description for the main model to continue reasoning. Use it when your main model lacks native image support but needs OCR, screenshot analysis, or visual understanding. Install globally via npm or run with npx, then configure VISION_API_BASE and related environment variables. Note: an external vision API key and quota are required, and DSH upgrades overwrite the image-downgrade patch.
dsh-vision-mcp 是 DSH 插件市场的零依赖 MCP 服务器,为 DeepSeek 等纯文本主模型赋予视觉能力。核心提供 img2text 工具,将本地路径、URL、data URL 或 base64 图片转交 OpenAI 兼容视觉 API(GPT-4o、Qwen-VL、GLM-4V、Ollama 等),返回文字描述供主模型继续推理。使用场景:当主模型不支持图片但需读图、OCR 或分析截图时,通过 npm 全局安装或 npx 临时调用,配置 VISION_API_BASE 等环境变量即可接入任意 MCP 客户端。注意事项:依赖外部视觉 API 密钥与额度;DSH 升级后需重跑 dsh-vision-mcp-patch 重新打补丁。
请帮我了解并安装插件:【dsh-vision-mcp】【https://github.com/moton16/dsh-vision-mcp】Send this message to DSH in your current session. CLI install commands may not be accurate across systems — DSH will figure it out for you.把上面这条消息直接发给当前会话里的 DSH,让它帮你了解并安装。安装命令不一定准确,发给 DSH 更稳。
Or use CLI install (for developers)或使用命令行安装(适合开发者)
CLI Install命令行安装
dsh plugin --profile web add github:moton16/dsh-vision-mcp把 moton16/dsh-vision-mcp 加入你的 DSH 配置(web profile)即可启用。
READMEREADME
DSH-vision-mcp · 识图 MCP(零依赖)




给本身不支持图片输入的模型(DeepSeek、纯文本模型等)装上"眼睛"的 MCP 服务器。
主模型调用 MCP 工具 img2text → 服务器读取图片(本地路径 / URL / data URL / base64)→ 转发给外部 OpenAI 兼容视觉 API(GPT-4o、Qwen-VL、GLM-4V、本地 Ollama 等)→ 把视觉模型返回的文字描述交回主模型继续推理。
主模型(纯文本)  --img2text(image, prompt)-->  dsh-vision-mcp
                                                   │ 读取图片 → base64
                                                   ▼
                                          外部视觉 API(VISION_API_BASE + VISION_MODEL)
                                                   │ 文字描述
                                                   ▼
主模型拿到文字描述,继续推理/回答
- 零依赖:仅用 Node.js 内置模块(Node ≥ 18,含
fetch),无需npm install - 标准 MCP stdio 协议,兼容 Claude Code / Cursor / Claude Desktop / Cline 等一切 MCP 客户端
- 支持 OpenAI 兼容协议的任意厂商与自建网关,
prompt可自定义(通用描述 / OCR / 报错分析等)
一行安装(npm / GitHub)
# 方式一:npm 全局安装(发布到 npm 后)
npm i -g dsh-vision-mcp

# 方式二:直接从 GitHub 安装(无需等 npm 发布)
npm i -g github:你的用户名/dsh-vision-mcp

# 方式三:不安装,临时跑(npx)
npx dsh-vision-mcp
安装后生成 dsh-vision-mcp 命令,在任意 MCP 客户端里这样配置:
{
  "mcpServers": {
    "dsh-vision": {
      "command": "dsh-vision-mcp",
      "env": {
        "VISION_PROVIDERS": "[{\"name\":\"qwen\",\"base\":\"https://dashscope.aliyuncs.com/compatible-mode/v1\",\"model\":\"qwen3-vl-flash\",\"apiKey\":\"sk-xxx\"}]"
      }
    }
  }
}
也可以不装包,直接用
node跑仓库里的server.js:"command": "node", "args": ["/path/to/server.js"]。
文件
| 文件 | 说明 |
|---|---|
server.js |
MCP 服务器本体(stdio 传输,零依赖,含 bin 入口) |
patch-dsh.js |
DSH 图片降级补丁脚本(bin: dsh-vision-mcp-patch) |
package.json |
npm 包定义(两个 bin) |
cordis.yml / cordis.patch.yml |
DSH 集成条目(MCP server 注册 + 视觉模型链配置) |
测试工具(mock-api / test-client / concurrent-test)为本地开发件,不随仓库分发;开发验证见
docs/DEVELOPER.md(本地文档)。
环境变量
| 变量 | 必填 | 默认 | 说明 |
|---|---|---|---|
VISION_API_BASE |
是 | https://api.openai.com/v1 |
OpenAI 兼容 API 地址(不含 /chat/completions) |
VISION_MODEL |
是 | gpt-4o-mini |
视觉模型名 |
VISION_API_KEY |
否* | 空 | API 密钥;本地 Ollama 等免 key 服务可省略 |
VISION_MAX_TOKENS |
否 | 4096 |
最大输出 token |
VISION_TEMPERATURE |
否 | 0.5 |
采样温度 |
VISION_TIMEOUT_MS |
否 | 120000 |
请求超时(毫秒) |
快速验证(本地 mock,无需任何 key)
本地开发件(docs/DEVELOPER.md 有完整说明):从开发备份取回 mock-api.js / test-client.js / test.png 后:
# 终端 1:启动 mock 视觉 API
node mock-api.js

# 终端 2:跑端到端测试(initialize → tools/list → tools/call)
$env:VISION_API_BASE='http://localhost:9876/v1'
$env:VISION_MODEL='mock-vision-1'
node test-client.js .\test.png
预期输出:7 项 [PASS],工具返回 MOCK_VISION_OK ... received_image_base64_chars=96,
证明"图片 base64 已送达视觉 API、文字描述已回传"的链路是通的。
接入 MCP 客户端
Claude Code
claude mcp add dsh-vision -- node /绝对路径/server.js
或写入 MCP 配置文件(~/.claude.json / 项目 .mcp.json):
{
  "mcpServers": {
    "dsh-vision": {
      "command": "node",
      "args": ["/path/to/dsh-vision-mcp/server.js"],
      "env": {
        "VISION_API_BASE": "https://api.openai.com/v1",
        "VISION_MODEL": "gpt-4o",
        "VISION_API_KEY": "sk-你的密钥"
      }
    }
  }
}
Cursor / Claude Desktop / Cline
在各自的 MCP 配置里按同样格式添加一个 stdio 类型 server:
command=node,args=[server.js 绝对路径],env 同上。
"对话框直插图片"的客户端适配
img2text 工具对任何标准 MCP 客户端到手即用:使用时机、图片附件引用格式([图片附件:名称] 图片文件:<绝对路径>)、prompt 规则、转述要求等行为规范已内置在工具描述里,任何 agent 看工具描述即懂,无需额外指令文件(无需 CLAUDE.md / AGENTS.md / rules)。
但在对话框直接粘贴/拖拽图片发送时,纯文本主模型收不了图片,各客户端需要一点额外适配才能"直插即读":
DSH(DeepSeek Harness)
需要打服务端图片降级补丁,一条命令(自动定位 DSH 的 bundle、幂等、改前备份、改后语法校验失败自动回滚):
dsh-vision-mcp-patch            # 打补丁(安装后即有该命令;或 node patch-dsh.js)
dsh-vision-mcp-patch --check    # 检查是否已打
dsh-vision-mcp-patch --restore  # 回滚(从 .image-vision.bak 恢复)
补丁把 prompt 准入从"拒绝"(MODEL_DOES_NOT_SUPPORT_IMAGES)改为图片降级:图片落盘为 durable attachment,消息中插入一行文本引用([图片附件:name(mediaType)] 图片文件:<绝对路径>),agent 按工具描述自动调 img2text —— 对话框直插图片即用。
补丁直接改
node_modules里的构建产物,DSH 升级会被覆盖,升级后重跑一次dsh-vision-mcp-patch即可。
Claude Code
主模型不支持图片时直插会被拒。工具描述已内置行为规范(agent 看到图片引用会自动调 img2text),但"直插图片自动落盘转引用"需要钩子(hook)把附件路径注入消息文本,思路同 DSH 降级:图片落盘 → 消息里出现 [图片附件:name] 文件:<绝对路径> → agent 调 img2text。
Cursor / 其他
工具描述已覆盖行为规范,无需额外指令;直插图片若被客户端拦截,同样需要钩子/脚本把附件转成路径文本。
各家视觉 API 配置示例(任选其一)
| 厂商 | VISION_API_BASE |
VISION_MODEL |
key 变量 |
|---|---|---|---|
| OpenCode Zen | https://opencode.ai/zen/v1 |
mimo-v2.5-free(免费、支持视觉) |
OPENCODE_API_KEY |
| Lunora | https://api.uselunora.com/v1 |
gemini-3-flash 等 |
key 写死在 providers 或环境变量 |
| OpenAI | https://api.openai.com/v1 |
gpt-4o / gpt-4o-mini |
VISION_API_KEY |
| 通义千问 VL | https://dashscope.aliyuncs.com/compatible-mode/v1 |
qwen-vl-max / qwen2.5-vl-72b-instruct |
VISION_API_KEY(DashScope key) |
| 智谱 GLM-4V | https://open.bigmodel.cn/api/paas/v4 |
glm-4v-flash / glm-4v-plus |
VISION_API_KEY |
| DeepSeek | https://api.deepseek.com/v1 |
deepseek-vl2(若账号开通) |
VISION_API_KEY |
| 本地 Ollama | http://localhost:11434/v1 |
qwen2.5vl:7b / llama3.2-vision |
免 key |
| OpenRouter | https://openrouter.ai/api/v1 |
openai/gpt-4o 等 |
VISION_API_KEY |
只要服务端实现了 OpenAI
POST /chat/completions且支持image_url内容块,即可接入。
多供应商 fallback(限流自动切换)
VISION_PROVIDERS 配置一组模型,调用时按顺序尝试:429 限流 / 5xx / 网络错误 / 超时 / 空内容自动换下一个,全部失败才报错;成功结果带 [provider: 名字] 标注。JSON 数组格式:
$env:VISION_PROVIDERS = '[{"name":"zen","base":"https://opencode.ai/zen/v1","model":"mimo-v2.5-free","apiKey":"zen-key"},
                          {"name":"glm","base":"https://open.bigmodel.cn/api/paas/v4","model":"GLM-4.6V-Flash","apiKey":"glm-key"},
                          {"name":"qwen","base":"https://dashscope.aliyuncs.com/compatible-mode/v1","model":"qwen3-vl-flash","apiKey":"qwen-key"}]'
DSH 的 cordis.patch.yml 中已内置默认:zen(mimo-v2.5-free, key 读 OPENCODE_API_KEY) → glm(GLM-4.6V-Flash) 双套兜底;设置 VISION_PROVIDERS 环境变量可整体覆盖。
思考模式控制(读图建议关闭)
每个 provider 可加 "reasoning" 字段:"none"(关闭思考,读图更快更省)/ "low" / "medium" / "high"。设置后下发 reasoning_effort 且不再发 temperature(部分模型两者冲突)。全局兜底可用环境变量 VISION_REASONING。留空 = 按模型默认。
$env:VISION_PROVIDERS = '[{"name":"lunora","base":"https://api.uselunora.com/v1","model":"gemini-3-flash","apiKey":"lunora-key","reasoning":"none"}]'
实测:Lunora(gemini-3-flash) 接受
reasoning_effort:"none"(响应 5.2s → 3.5s);智谱 GLM 不接受该参数(思考照开),故只对已验证的厂商配置关闭。
工具说明
img2text
| 参数 | 必填 | 说明 |
|---|---|---|
image |
是 | 图片:本地绝对路径 / http(s) URL / data: URL / 纯 base64 |
prompt |
否 | 分析指令,如"详细描述"、"逐字提取全部文字(OCR)"、"这张报错截图的关键信息" |
max_tokens |
否 | 覆盖最大输出 token |
默认提示词要求:逐字提取可见文字、描述布局与元素关系、完整还原截图/代码/图表中的信息,只描述可见内容。
实测结果
- 本地路径输入:
initialize✓tools/list✓tools/call✓(7 项全过,exit 0) - data URL 输入 + 自定义 prompt:7 项全过,prompt 正确透传(exit 0)
- 图片以
data:mime;base64,...形式随请求送达视觉 API(mock 校验received_image_base64_chars=96= 70 字节 PNG)
现成的同类 MCP(不想自维护可选这些)
| 项目 | 特点 |
|---|---|
| xiayangqun/Read-Image-MCP | OpenAI 兼容视觉模型;describe / ocr / structured 三模式;path/url/base64/data_url 四来源 |
| kitlau86/agent-vision-mcp | OpenAI 兼容 API(Gemini / Qwen-VL / OpenAI / 自托管均可),analyze_image 单工具 |
| JochenYang/luma-mcp | 多国产模型(GLM-4.6V / DeepSeek-OCR / Qwen3-VL-Flash 等),大图自动裁剪,支持 HTTP 部署 |
| bcdxc/visual-understand-mcp | PyPI 安装,VISION_API_BASE / VISION_MODEL / VISION_API_KEY 三变量即可用 |
| winton979/vision-mcp | 单工具多 task(ocr/ui_review/table/diagram/chart…),markdown/json/plain_text 三种输出结构 |
| systemmin/image-mcp | Anthropic / 智谱 / Ollama 三后端动态切换,多图对比 |
| pongsakornp/vision-mcp | Gemini→Grok→OpenRouter 自动 fallback,支持视频 |
Related相关推荐
-
 ysr666/dsh-vision-router
Eyes for text-only DeepSeek Harness agents: built-in free vision chain (no key) + pixel-level vision tools (Q&A, groundi…
-
 Mars-Sea/dsh-commandcode-provider
Command Code provider plugin for DeepSeek Harness (dsh). Adds Command Code model access, live model catalog, plan-aware …
-
 franksong2702/dsh-codex-connect
Use openai-codex models and image generation via ChatGPT OAuth for DeepSeek Harness.
-
 Stormycry-cryp/dsh-AuthInOne
Self-contained DeepSeek Harness (DSH) plugin for Provider/Auth login, model switching, image fallback, token/cost analyt…
-
 labring/sealos-skills
AI agent skills for Sealos — deploy any project, provision databases, object storage & more with one command. Works with…
-
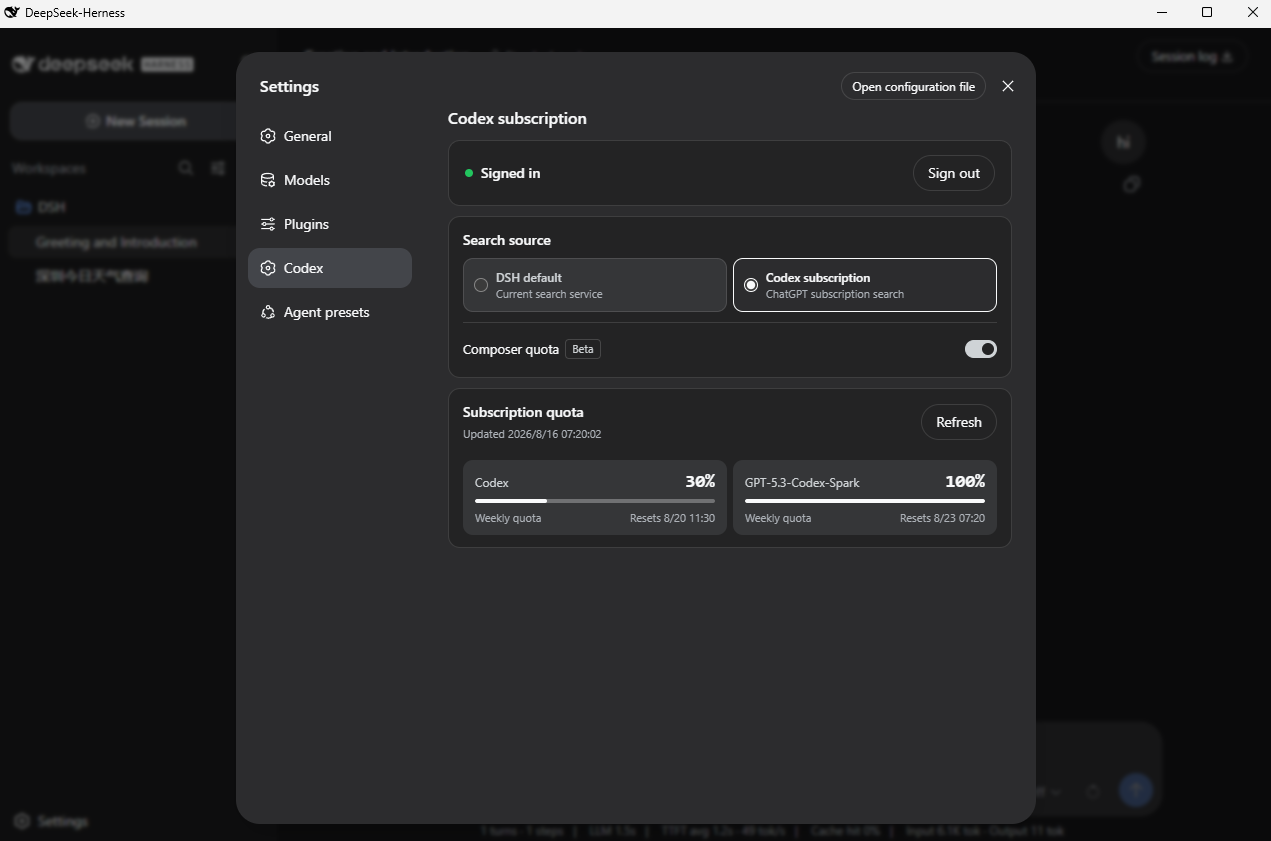 WSL043/dsh-codex-subscription
把 ChatGPT / Codex 订阅接入 DeepSeek Harness:OAuth、模型、额度、搜索和图片生成,无需 API Key 或 Codex CLI。
-
 BlockRunAI/dsh-clawrouter
A safety gate for DeepSeek Harness: a stronger model reviews dangerous tool calls before they run. Plus vision and Block…
-
 MJorgin/dsh-media-skills
Free image reading & generation for DeepSeek Harness (rc.7 / rc.8 / v0.1.1-rc.1 / rc.2 / v0.1.2-alpha.3) — paste-image r…